12|提高重排序竞争力
本课目标: 区分被召回与在候选中被选用。
原文题名: 不仅要被检索到,还要在重排序阶段胜出
技术背景
初步检索通常拉回 50-100 个候选内容块,经过重排序筛选后只有几块到十几块能进入最终 Prompt。重排序常见做法包括交叉编码器、LLM 评分、规则融合等。它们共同关心的问题是:这个内容块是否真正回答了用户的问题。
GEO 策略
直接回答用户意图,提高信息密度,在重排序阶段胜出竞品。
落地动作
- 直接回答用户的搜索意图——用户问「怎么做」就给步骤,不要给定义
- 去除「众所周知」「值得注意的是」这类零信息量的套话
- 每句话都要带增量信息
- 控制单页信息密度:宁可拆成多页让每页精炼
图解
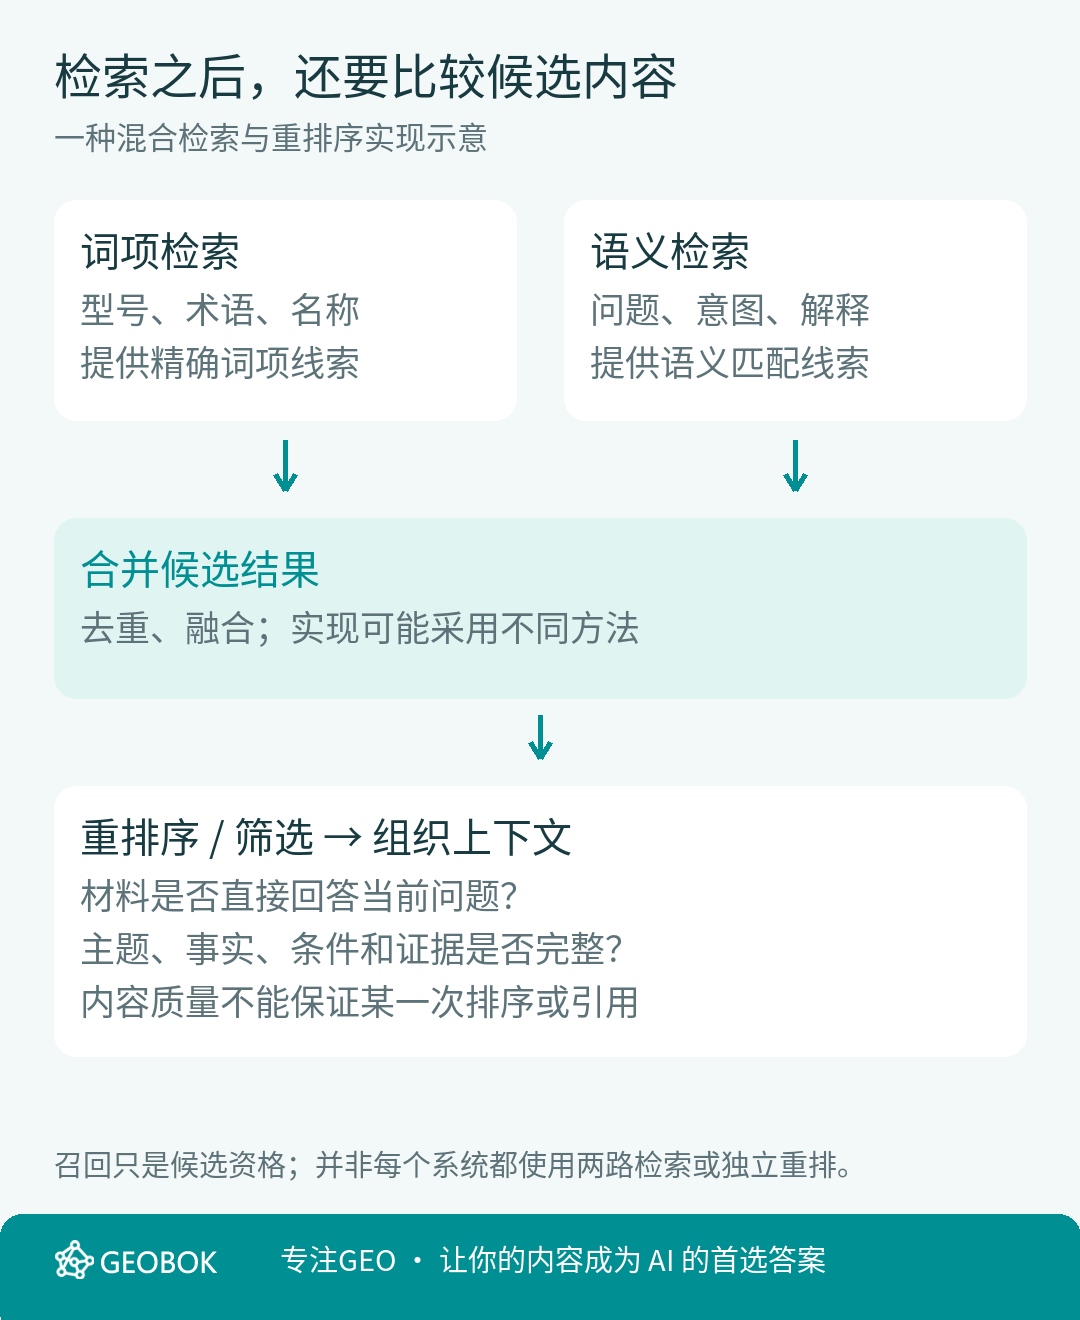
精确词项与语义线索可形成不同候选集合。合并、重排和上下文选择决定后续材料;此图不代表所有产品的固定实现。
因果逻辑详解
重排序跟初步检索的精度不同。初步检索追求速度和覆盖面,精度相对粗;重排序则对已缩小的候选集做精细评估,判断每个块与用户问题的真正相关度。
一段 200 字里有 100 字是「众所周知,数据库在现代应用中扮演着重要角色……」这类废话的内容,虽然关键词齐全、初步检索能拉到,但到了重排序阶段,系统会判断:这段话没有真正回答问题,相关性分数低,淘汰。你输给竞品,不是输在检索阶段,而是输在重排序阶段。
搜索意图匹配也很关键:用户问「Python 连接 MySQL」的意图是「怎么做」,不是「什么是 MySQL」。首段直接给步骤而不是给定义,更容易被重排序模型判为高度相关。
相关策略: 策略 05(信息前置)、策略 11(混合检索适配)
动手练习
比较两篇回答同一问题的页面,按相关性、证据和适用条件列出差异,不推断平台内部打分。
完成后,记录你改了什么、依据是什么、还有哪些条件没有验证。
GEOBOK · 专注GEO · 让你的内容成为 AI 的首选答案